accueilinsightsPerformance applicative : la Data d’abord, l’IA ensuite
data & AIquality assurance & testing

Performance applicative : la Data d’abord, l’IA ensuite

Didier Nizard & Franck Jarre · novembre 19, 2000

Et si le principal défi de l’IA appliquée à la performance n’était pas l’algorithme, mais la qualité des données qu’on lui confie ?

La valeur ne dépend pas du volume de données collectées. Elle naît de données fiables, contextualisées et corrélées, capables d’éclairer une décision. L’IA accélère l’analyse ; elle ne remplace pas ce socle.

Temps de réponse, erreurs, CPU, mémoire, métriques Kubernetes, logs, traces, événements de déploiement : les systèmes d’information produisent déjà une masse de signaux. Le défi consiste à leur donner du sens.

Une transaction passe de 800 ms à 2,5 secondes pendant un test de charge. Le ralentissement est mesuré, mais sa cause reste inconnue : saturation CPU, base de données, dépendance externe ou régression introduite par la dernière version ? Pour le comprendre, il faut rapprocher les données. C’est la complémentarité de NeoLoad et de l’écosystème Grafana : l’un mesure la performance dans des conditions maîtrisées, l’autre fournit le contexte nécessaire au diagnostic.

NeoLoad : mesurer dans des conditions maîtrisées

Avec NeoLoad, on ne se contente pas d’observer le système : on définit les conditions du test. Utilisateurs simultanés, montée en charge, endurance, stress, parcours métier, volumétries et transactions critiques composent des campagnes reproductibles. Leur historique permet de répondre à des questions concrètes : cette version est-elle plus lente ? À quel palier la dégradation apparaît-elle ? Une optimisation a-t-elle réellement fonctionné ?

Encore faut-il comparer ce qui est comparable. Première règle : examiner les percentiles p95 et p99, pas seulement la moyenne. Ce sont souvent les temps de réponse les plus élevés qui compromettent un objectif de service. Deuxième règle : conserver le même jeu de données, le même état de plateforme et la même phase de chauffe, puis répéter les tests pour mesurer la variabilité naturelle. Deux exécutions isolées avec 10 % d’écart ne suffisent pas à conclure ; trois exécutions stables suivies d’un écart comparable constituent un signal de régression bien plus solide.

Intégrées à la chaîne CI/CD sous forme de quality gates, ces mesures deviennent un critère de livraison : une version qui ne respecte pas les objectifs de service (SLO) d’une transaction critique ne progresse pas vers la production.

La représentativité reste essentielle. Elle concerne les scénarios, mais aussi le dimensionnement de la plateforme, ses données et ses dépendances, y compris celles simulées. Sans environnement crédible, les résultats se transposent difficilement en production.

Grafana : comprendre ce qui se passe derrière les chiffres

NeoLoad indique quand la performance se dégrade. Grafana aide à comprendre ce qui se produit au même moment : métriques dans Mimir, logs dans Loki et traces dans Tempo, réunis dans une même interface. Une hausse des temps de réponse, rapprochée de la saturation d’un composant ou d’une dépendance anormalement lente, devient une piste de diagnostic exploitable.

Les tests d’endurance illustrent bien cet apport. Une fuite mémoire ou une dérive du garbage collector peut apparaître après plusieurs heures de charge stable. C’est l’évolution des courbes, et non une mesure isolée, qui la révèle.

Pour que cette lecture soit utile, trois conditions comptent. D’abord, instrumenter la plateforme de test avec autant de rigueur que la production ; on peut même y conserver toutes les traces lorsque la production doit les échantillonner. Ensuite, collecter les métriques applicatives (pools de connexions, threads, garbage collector, files d’attente) au-delà du seul CPU et de la mémoire. Enfin, adopter un langage commun : OpenTelemetry permet de suivre une transaction entre services sans dépendre d’un format propriétaire.

La valeur se crée dans la corrélation

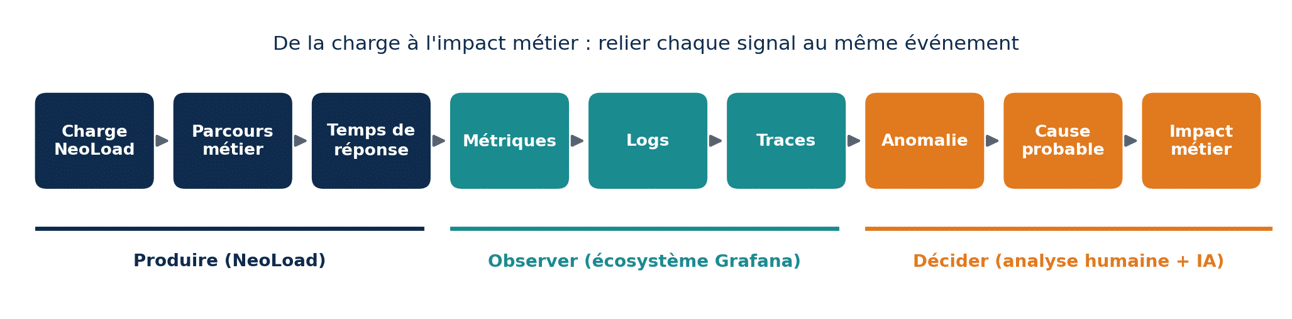
QA, développement, infrastructure, SRE et équipes métier disposent chacun d’une partie de l’explication. Il ne s’agit pas d’ajouter un tableau de bord, mais de relier les signaux autour d’un même événement, de la charge injectée jusqu’à l’impact métier.

LA CHAÎNE DE LECTURE
Charge NeoLoad → parcours métier → temps de réponse → métriques → logs → traces → anomalie → cause probable → impact métier. La mesure et l’observabilité nourrissent ensuite l’analyse humaine, éventuellement assistée par l’IA.

Quatre prérequis rendent cette chaîne possible : synchroniser les horloges des injecteurs et de la plateforme ; annoter dans Grafana les campagnes, leurs paliers et les versions testées ; exporter les séries NeoLoad (utilisateurs actifs, débit, temps de réponse) vers Mimir, via API ou exporter ; enfin, propager le contexte de trace. En injectant les en-têtes W3C Trace Context, NeoLoad permet de retrouver dans Tempo les appels simulés et leurs identifiants.

La conséquence devient alors lisible : panier impossible à valider, paiement ralenti ou traitement hors SLO. On passe d’un symptôme technique à un impact métier identifiable.

EXEMPLE ILLUSTRATIF
NeoLoad monte progressivement à 3 000 utilisateurs. Dès 2 200, le p95 de « validation du panier » passe de 600 ms à 1,8 s, tandis que les autres étapes restent stables. Dans Grafana, le palier correspond à la saturation à 100 % du pool de connexions à la base de données. Les traces Tempo montrent que les transactions lentes attendent plus d’une seconde une connexion. Après redimensionnement du pool et réécriture d’une requête, un nouveau test mesure 650 ms au p95 à 3 000 utilisateurs. La corrélation a orienté l’investigation vers la bonne cause, plutôt que d’incriminer globalement la base de données.

L’IA dépend d’abord de la qualité des données

L’IA peut explorer la télémétrie, détecter des anomalies, rapprocher des signaux et accélérer les investigations. Elle ne peut toutefois pas reconstituer une information jamais collectée. Des scénarios peu représentatifs, des transactions mal définies ou des traces privées de contexte conduisent simplement à produire plus vite des analyses trompeuses.

Une stratégie IA appliquée à la performance commence donc par des choix de Data : quelles données collecter, à quelle granularité, pendant combien de temps, et avec quels indicateurs de l’expérience utilisateur ? Sur cette base, des outils comme Grafana Assistant et Assistant Investigations, dans Grafana Cloud, facilitent l’interrogation de la télémétrie en langage naturel. L’expert reste responsable du contexte, de l’interprétation causale et de la décision.

Notre conviction

L’avenir du test de performance ne se résume ni à injecter davantage de charge ni à multiplier les dashboards. Il repose sur la capacité à faire parler les données. Itecor Paris accompagne ses clients sur toute cette chaîne : scénarios pertinents et environnements représentatifs, mesures fiables avec NeoLoad, observabilité structurée avec Grafana et OpenTelemetry, corrélation des signaux et préparation des usages assistés par l’IA.

Trois questions pour votre organisation

Trois « oui » : vous disposez d’un socle solide pour exploiter l’IA. Un « non » : vous avez identifié une priorité concrète.

EN UN MOT

Avant de demander à l’IA pourquoi une application ralentit, donnons-lui les bonnes données, au bon moment et dans le bon contexte. L’IA peut devenir le copilote ; la Data reste le carburant.

Vous souhaitez évaluer la maturité de votre chaîne performance et observabilité ? Nos experts NeoLoad et Grafana vous proposent un échange de 30 minutes.

plus d'insights

Tricentis Transform London 2026 : l’IA agentique redéfinit les frontières de l’ingénierie de la qualité


company newsdata & AIquality assurance & testing

octobre 30, 2026

Enjeux et bénéfices liés à la mise en œuvre d’un assistant IA conversationnel


data & AIdigital solutions

octobre 13, 2026
Prochain Itecor Testing Breakfast – L’IA au service de la qualité logicielle et de la création de valeur


data & AIquality assurance & testing

octobre 12, 2026